L'illusion de l'IA : pourquoi alimenter un LLM sans gouvernance des données est un risque impossible à auditer
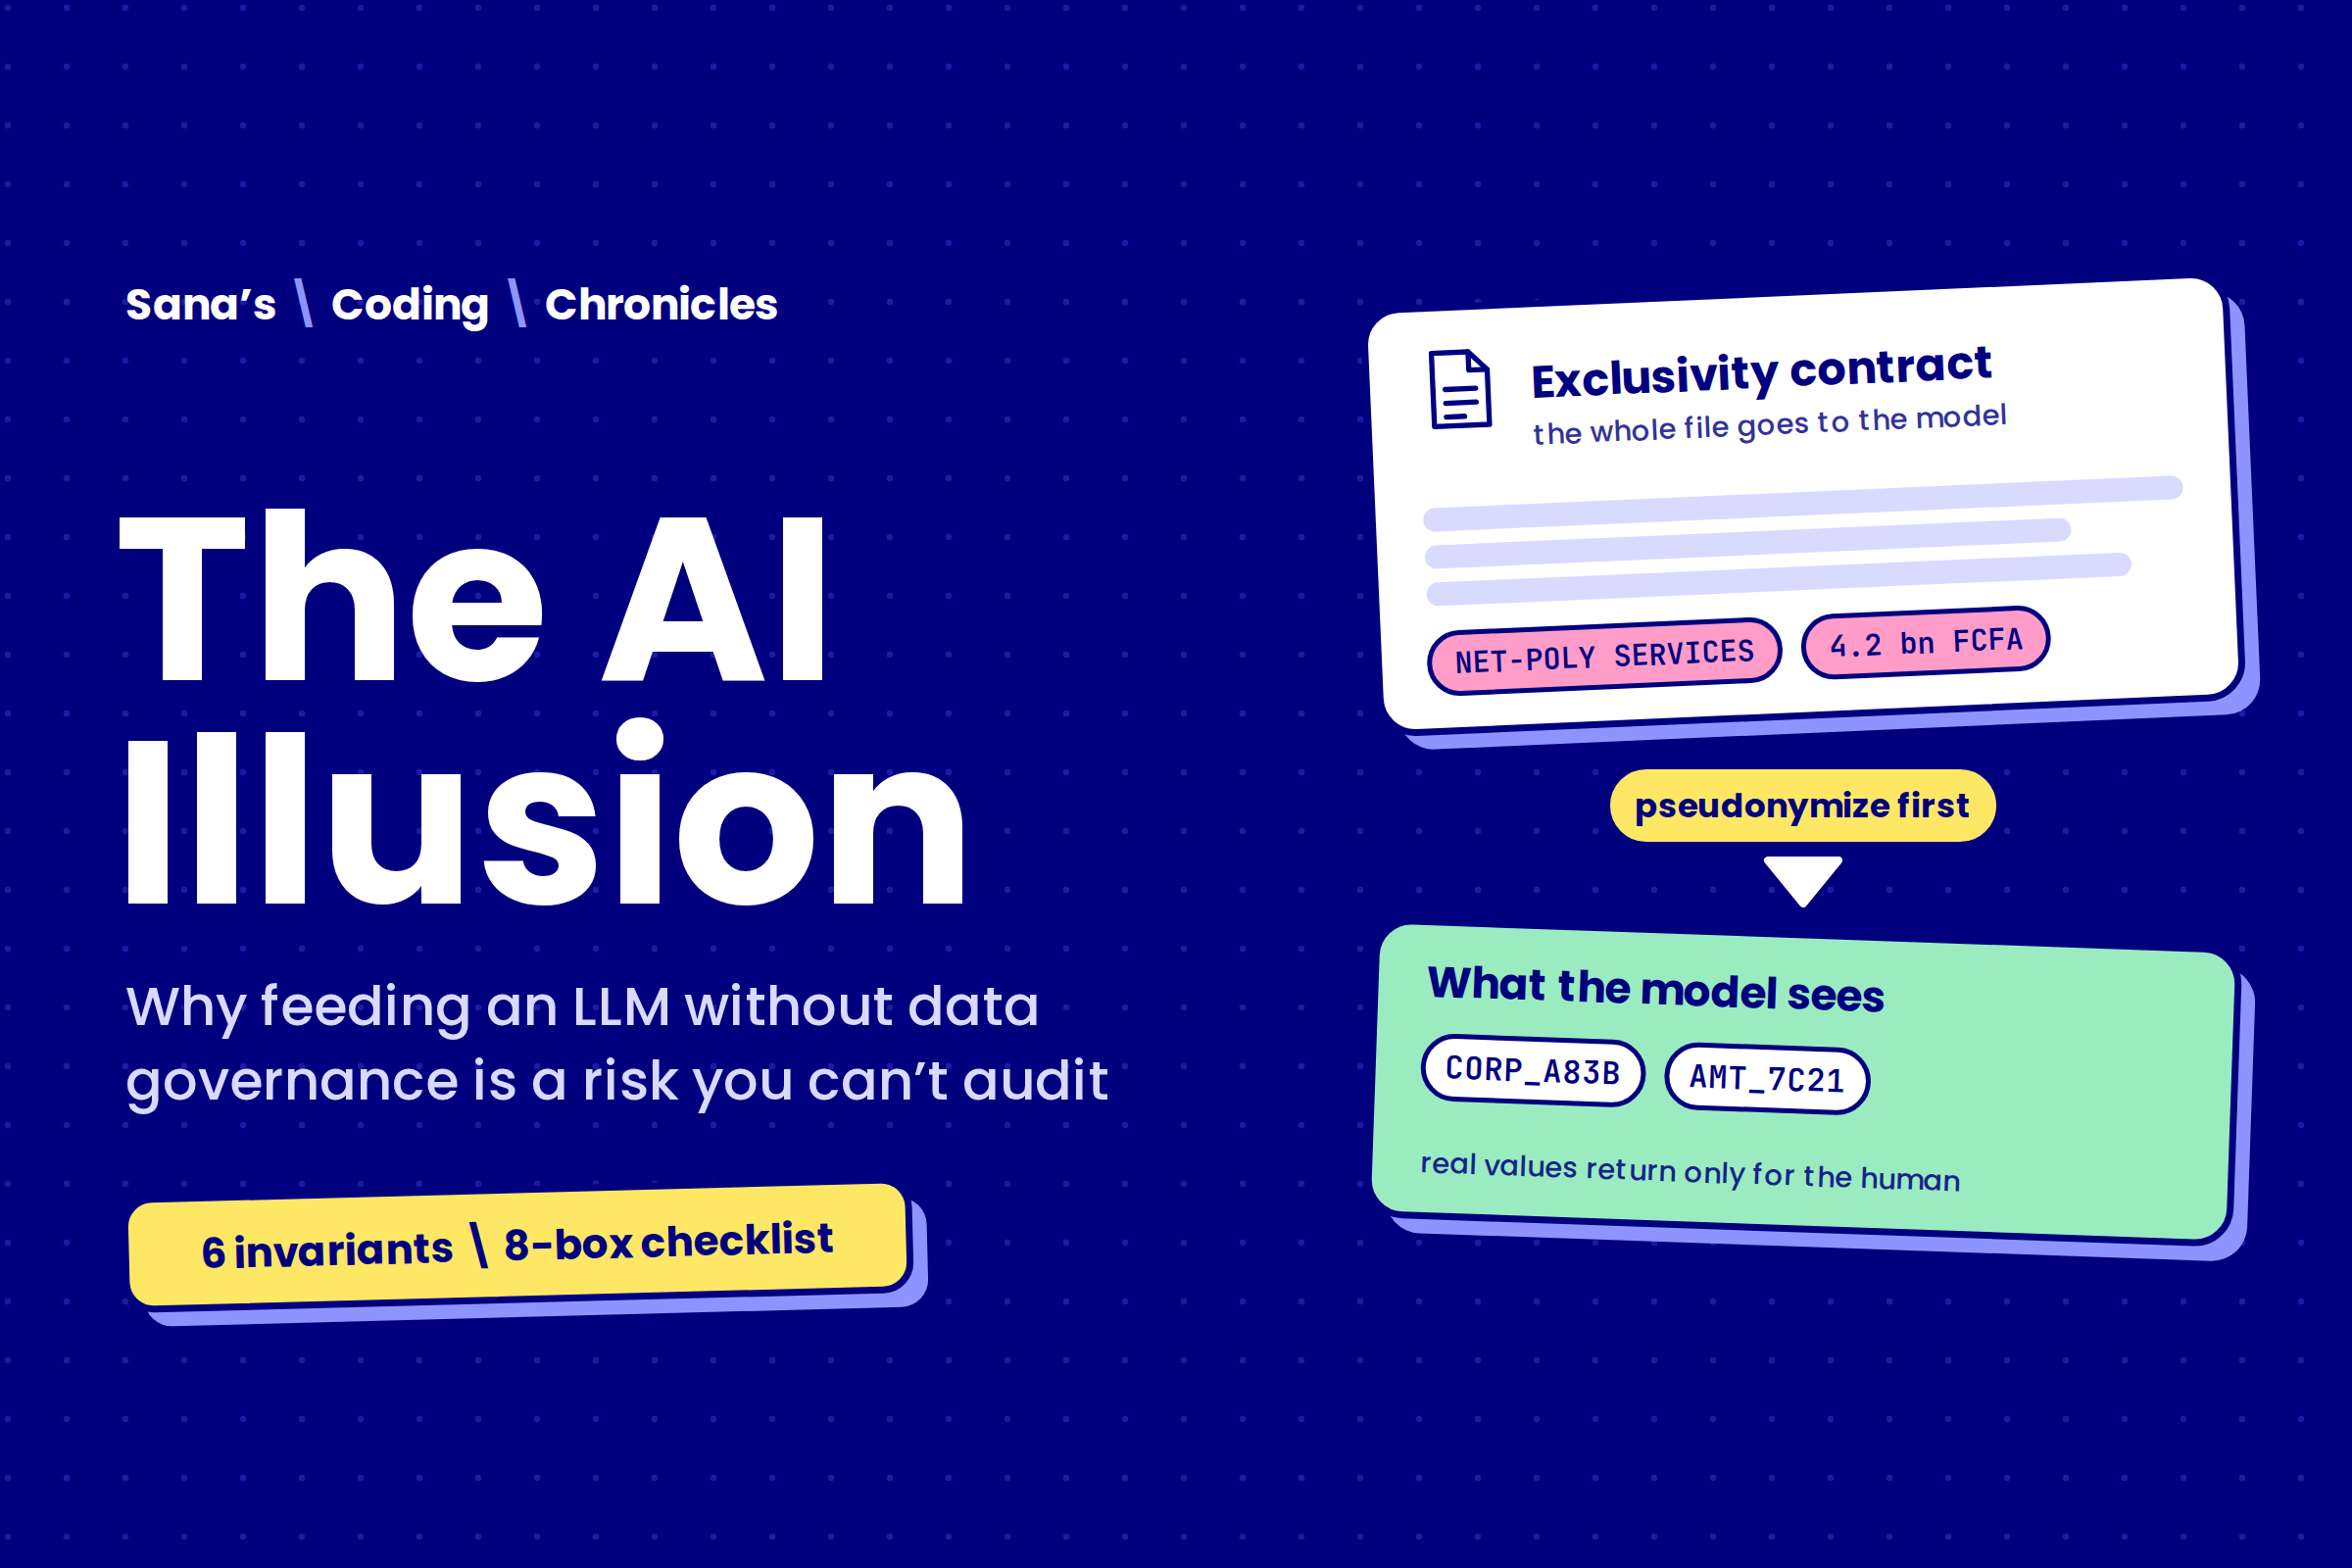
Table of Contents
- 1. Le problème : chaque requête emporte vos données
- 2. Pourquoi l’anonymisation naïve échoue
- 3. Les six invariants d’une gouvernance robuste
- Invariant 1 : Minimiser dès la source
- Invariant 2 : Ne jamais laisser un modèle trancher ce qu’un chemin déterministe peut décider
- Invariant 3 : Traiter chaque frontière vers le modèle comme un point de protection obligatoire et réversible
- Invariant 4 : Réhydrater au tout dernier moment légitime
- Invariant 5 : Un garde-fou déterministe a le dernier mot sur la plausibilité
- Invariant 6 : Chaque saut d’agent à agent constitue sa propre frontière de confiance
- 4. Pour les ingénieurs : comment nous implémentons les invariants
- 5. Vérifier plutôt que présumer
- 6. La piste d’audit (Audit Trail)
- 7. Conclusion : L’IA est d’abord un défi de Data Engineering
Une juriste ouvre le nouvel assistant IA de l’entreprise, y dépose un contrat d’exclusivité et tape : « Résume les obligations clés en cinq lignes. » Dix secondes plus tard, elle obtient une synthèse claire et concise. C’est un gain de productivité concret, indéniable.
Ce qu’elle ne voit pas, c’est ce qui s’est réellement passé pendant ces dix secondes. L’application ne s’est pas contentée d’envoyer sa question : elle a transmis le contrat dans son intégralité — la contrepartie, les grilles tarifaires, les clauses de résiliation, le nom des signataires. Tout cela a atterri, sous forme de texte lisible en clair, sur un serveur exploité par un tiers.
Le même phénomène se reproduit lorsqu’un responsable RH demande le résumé d’un entretien d’évaluation, ou lorsqu’un analyste financier épluche le dossier de crédit d’un client. La question est courte. Le contexte qui l’accompagne est colossal.
Dans presque tous les comités de direction, le mot d’ordre pour 2026 est identique : « Il nous faut de l’IA, et tout de suite. » En quelques semaines, des clés d’API sont générées, des modèles de langage sont connectés aux bases de données internes, et des flux de travail entiers sont délégués à des algorithmes tiers. Les démos sont impressionnantes et les gains de productivité bien réels.
Cet article ne cherche pas à contester cet élan. Il soutient que les entreprises qui prendront la gouvernance des données au sérieux déploieront l’IA plus vite et sur un plus large périmètre, précisément parce que leurs fondations seront sûres. Celles qui font l’impasse dessus finiront par se heurter à une question toute simple à laquelle elles ne sauront pas répondre. Nous y reviendrons à la fin.
1. Le problème : chaque requête emporte vos données
Même lorsque votre contrat avec le fournisseur d’IA lui interdit d’entraîner ses modèles sur vos données, et même lorsque la connexion est intégralement chiffrée en transit, le texte brut arrive toujours sous une forme parfaitement lisible chez ce tiers. Les contrats encadrent ce que le fournisseur a le droit d’en faire. Mais ils ne changent absolument rien à ce qui se retrouve exposé en cas de compromission chez lui, en cas d’erreur de configuration dans ses logs, ou si une réquisition judiciaire atterrit sur son bureau.
Ce risque s’amplifie encore avec les architectures multi-agents, où un agent routeur délègue le travail à des sous-agents spécialisés partageant une mémoire commune. Un simple nom ou un chiffre d’affaires injecté dans cet état partagé devient immédiatement visible pour chaque agent de la chaîne, ainsi que pour chaque journal d’événements, chaque cache et chaque outil de traçabilité (tracing) dans lequel ils écrivent.
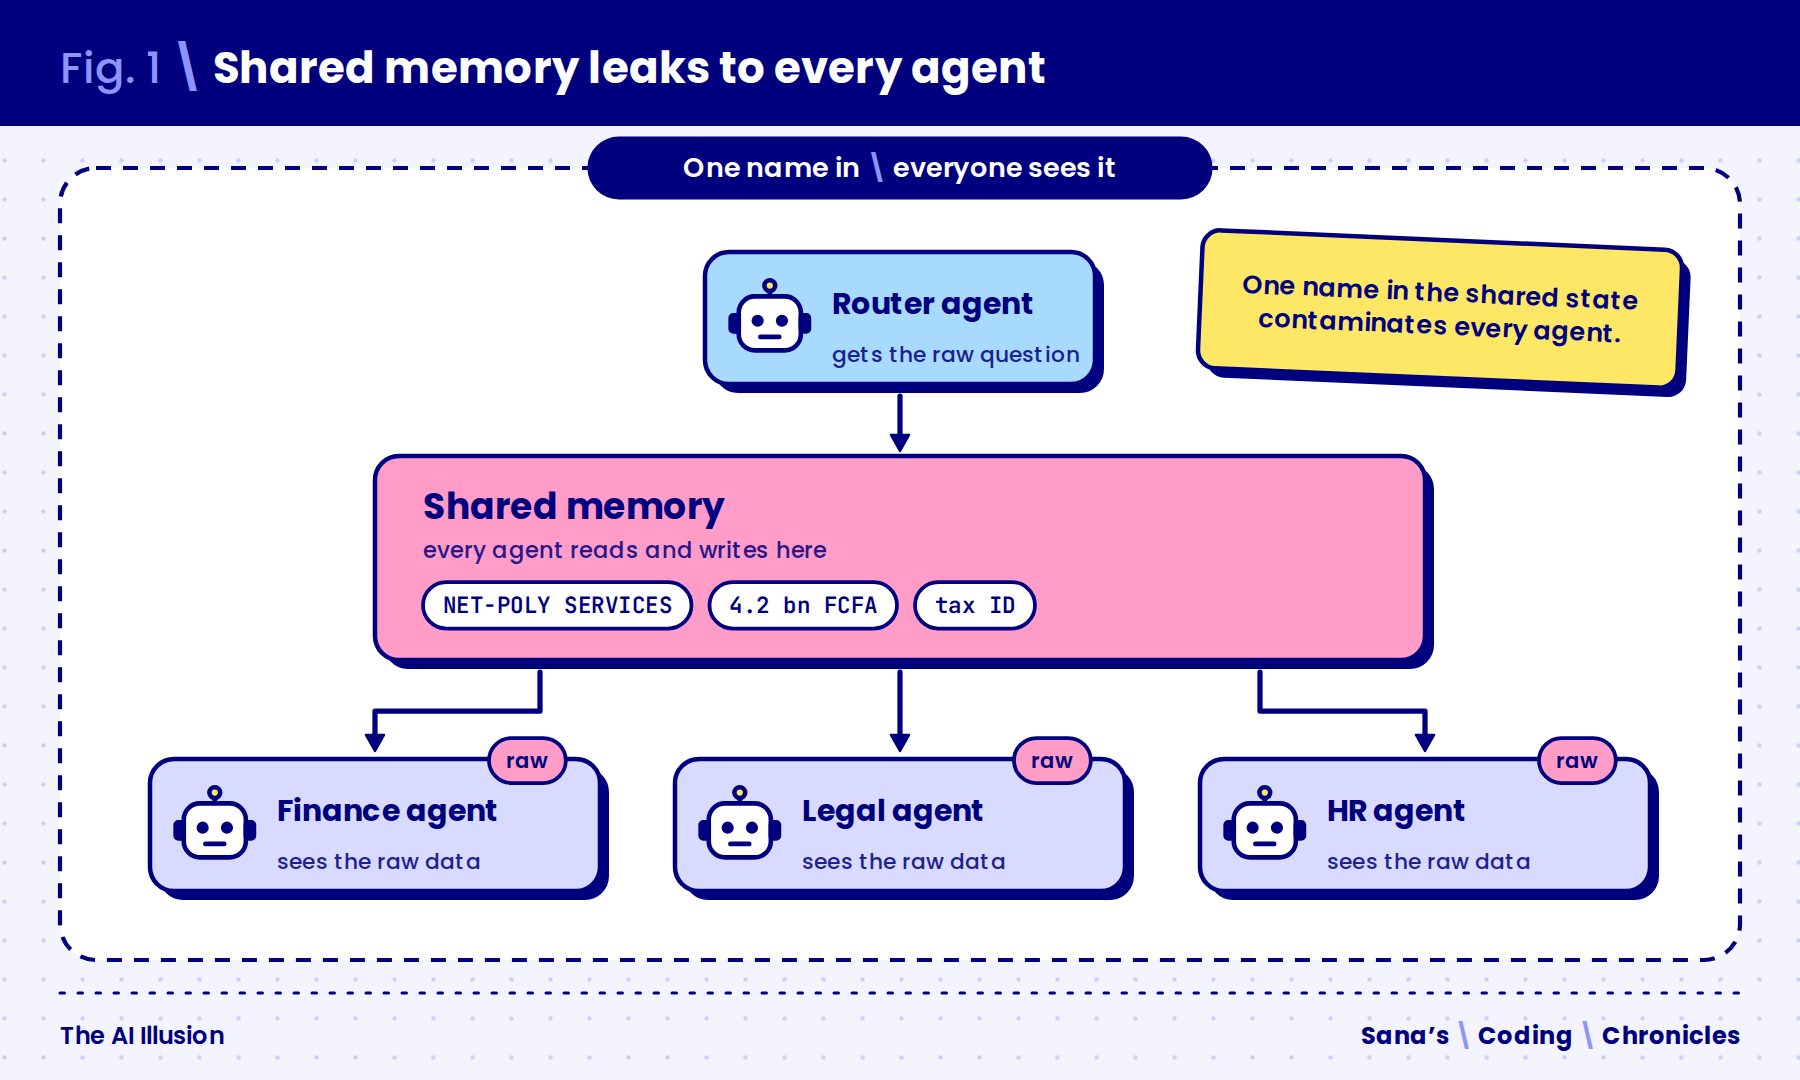 Figure 1 : Injection de données brutes dans une mémoire partagée multi-agents.
Envoyer des données métier brutes dans un LLM sans aucun contrôle n’est pas de l’innovation. C’est sous-traiter la mémoire stratégique de son entreprise à un tiers qui n’assumera jamais le coût de vos fuites.
2. Pourquoi l’anonymisation naïve échoue
Certaines équipes, conscientes du danger, placent un filtre rudimentaire en amont du modèle : des outils génériques de reconnaissance d’entités nommées (Named Entity Recognition ou NER), ou de simples expressions régulières qui masquent les noms propres. Sur le papier, cela semble raisonnable. En production, cette approche échoue généralement de trois manières — et son vrai danger est de procurer à la direction un sentiment trompeur de sécurité qui l’empêche de poser les bonnes questions.
Échec n°1 : Le filtre ne comprend pas votre métier
Les outils de détection génériques sont entraînés sur des textes courants. Ils confondent facilement les noms d’entreprises avec des termes du langage usuel (« Services », « Transit », « Holding »), et laissent régulièrement passer des raisons sociales contenant ce type de mot, comme « NET-POLY SERVICES ». Quant aux identifiants internes (numéros fiscaux, identifiants du registre de commerce, codes clients internes), ils ne correspondent pas aux formats standards internationaux et passent totalement inaperçus.
Échec n°2 : Masquer le nom ne revient pas à masquer l’entreprise
Considérez cet exemple :
- Texte brut : « L’entreprise X a réalisé 4,2 milliards de FCFA de chiffre d’affaires à Abidjan en 2024. »
- Après un filtre naïf : « ENTREPRISE_1 a réalisé 4,2 milliards de FCFA de chiffre d’affaires à Abidjan en 2024. »
Le nom a disparu, mais le chiffre d’affaires exact et la ville suffisent amplement à identifier l’entreprise en une seule recherche. Un modèle moderne, fort de son immense base de connaissances d’entraînement, peut souvent faire le lien en une fraction de seconde.
Échec n°3 : Un prompt est une prière, pas un contrôle
Une consigne comme « Ne répète jamais les noms des clients » n’est qu’une incitation probabiliste (probabilistic nudge). Le modèle s’y conformera le plus souvent… jusqu’au jour où il ne le fera pas. Le problème est encore plus pernicieux : selon le fournisseur et la configuration, certains modèles renvoient leur raisonnement intermédiaire dans un canal distinct de la réponse finale — une sorte de bloc-notes (scratchpad ou canal de pensée) qui vous est retourné. Si votre mécanisme de protection ne filtre que la réponse finale, les données brutes peuvent transiter par ce bloc-notes en toute liberté.
Croire qu’un prompt système enjoignant d’« être discret » protège vos données revient à verrouiller une porte blindée en laissant la clé sur la serrure extérieure.
3. Les six invariants d’une gouvernance robuste
Si les consignes et les filtres basiques ne suffisent pas, que faut-il mettre en place ? La plupart des architectes esquissent un pipeline linéaire : les données arrivent, sont filtrées, partent vers le modèle, puis reviennent. Un système robuste obéit à une tout autre logique : c’est une défense en profondeur, où chaque frontière porte sa propre protection, indépendamment des autres.
Voici six invariants fondamentaux. Ce sont des contrats d’architecture que tout concepteur de système peut vérifier au sein de sa propre infrastructure, quels que soient la stack technique, le fournisseur de modèles ou la taille de l’équipe.
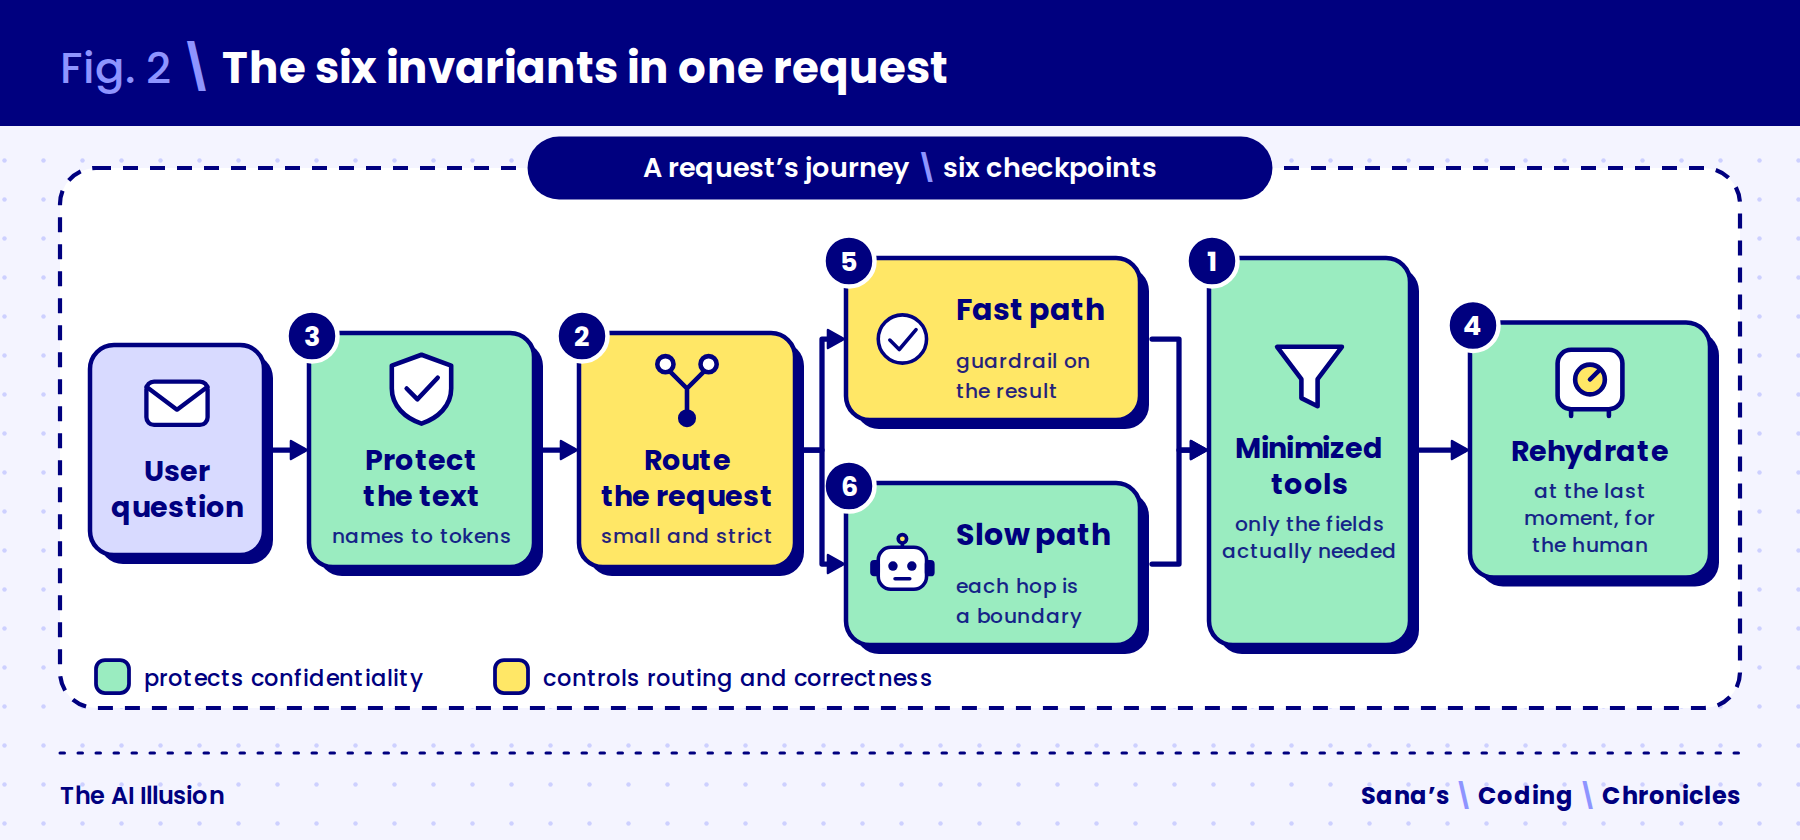 Figure 2 : Les six invariants de gouvernance des données appliqués aux flux LLM.
Invariant 1 : Minimiser dès la source
Ce qui ne figure pas dans les données transmises ne peut pas fuiter. Les outils exposés aux agents IA ne doivent jamais être les mêmes que ceux mis à disposition des développeurs humains. La pagination y est strictement imposée, les volumes sont plafonnés et les champs superflus sont intégralement supprimés. L’API ne renvoie pas un dossier client complet pour calculer un simple ratio : elle ne retourne que les trois nombres strictement nécessaires — sans coordonnées, sans adresses, sans noms.
Ce n’est pas une règle propre à l’IA : c’est un principe fondamental d’exposition des données que l’IA rend simplement impératif.
Invariant 2 : Ne jamais laisser un modèle trancher ce qu’un chemin déterministe peut décider
Un classement, la consultation d’un ratio ou une simple extraction d’information n’exigent aucun discernement : ils n’ont donc aucune raison de transiter par votre modèle le plus onéreux et le moins prévisible. L’aiguillage peut reposer sur une règle métier, un choix dans l’interface ou un classifieur très léger : le principe n’impose pas la méthode d’implémentation.
Deux remarques franches s’imposent. Premièrement, si le routeur est lui-même un modèle, il reste un modèle : choisissez-le miniature, strictement bridé, et ne lui fournissez que du texte anonymisé. Le but est de réduire la surface d’exposition, non de prétendre qu’elle a disparu. Deuxièmement, cet invariant présente un avantage qui convainc souvent un comité de direction bien avant les arguments sécuritaires : il est beaucoup plus économique et infiniment plus rapide.
Une anecdote révélatrice nous est fournie par Anthropic elle-même. En mars 2026, le code source de Claude Code a fuité accidentellement via une source map publiée par inadvertance sur npm. On y a découvert que l’outil détecte la frustration de l’utilisateur — c’est-à-dire si quelqu’un l’insulte — au moyen d’une simple expression régulière, sans faire appel au moindre modèle1. Une regex est instantanée et gratuite. Un appel d’inférence n’est ni l’un ni l’autre, pour une question qui ne réclame aucun jugement.
Invariant 3 : Traiter chaque frontière vers le modèle comme un point de protection obligatoire et réversible
Toute donnée franchissant la frontière entre votre système et un modèle de langage, qu’elle soit entrante ou sortante, doit être protégée par un mécanisme réversible tel que la substitution, la pseudonymisation ou la tokenisation. L’erreur courante consiste à ne protéger que le champ de réponse évident. Inspectez chaque canal exposé par le fournisseur, y compris le canal de raisonnement décrit à la section 2.
Une mise en garde juridique : des données pseudonymisées peuvent toujours être qualifiées de données à caractère personnel au sens de réglementations comme le RGPD. Cet invariant réduit votre exposition au risque opérationnel ; il ne vous exonère pas de vos obligations légales.
Invariant 4 : Réhydrater au tout dernier moment légitime
L’opération inverse de substitution ne doit être appliquée qu’à l’ultime étape, juste avant que la réponse ne soit présentée à un utilisateur humain habilité à consulter les valeurs réelles. Le modèle travaille à l’aveugle du début à la fin. Seul l’humain reçoit la réponse en clair, et exclusivement en bout de chaîne.
Invariant 5 : Un garde-fou déterministe a le dernier mot sur la plausibilité
Les quatre premiers invariants protègent la confidentialité. Celui-ci protège l’exactitude des résultats. Toute réponse générée doit franchir un contrôle non probabiliste — tel qu’un seuil limite ou une comparaison par rapport à un référentiel connu — avant d’être transmise. Si le résultat semble aberrant, le système bascule automatiquement sur un chemin surveillé plus lent plutôt que de laisser passer une réponse non vérifiée.
Invariant 6 : Chaque saut d’agent à agent constitue sa propre frontière de confiance
C’est l’invariant le plus souvent négligé, car il n’apparaît pas sur les diagrammes en couches statiques. La sortie d’un agent n’est pas automatiquement sécurisée pour l’agent qui l’a sollicité.
Voici le cas typique : un sous-agent, pensant bien faire en « nettoyant sa propre sortie » avant de répondre, désanonymise des données qui devaient impérativement rester masquées pour l’agent parent ayant délégué la tâche. Le sous-agent s’est conformé à ses consignes à la lettre. Il ignorait simplement que sa réponse était destinée à un autre maillon de la chaîne, censé poursuivre son raisonnement sur des pseudonymes.
Il existe un corollaire aggravant : lorsque l’historique conversationnel traverse plusieurs agents, les échanges de différents sous-agents se retrouvent mélangés dans un contexte unique. Sans un étiquetage explicite de la provenance (provenance tagging), il devient impossible de déterminer quelle frontière de confiance s’applique à quel fragment de texte.
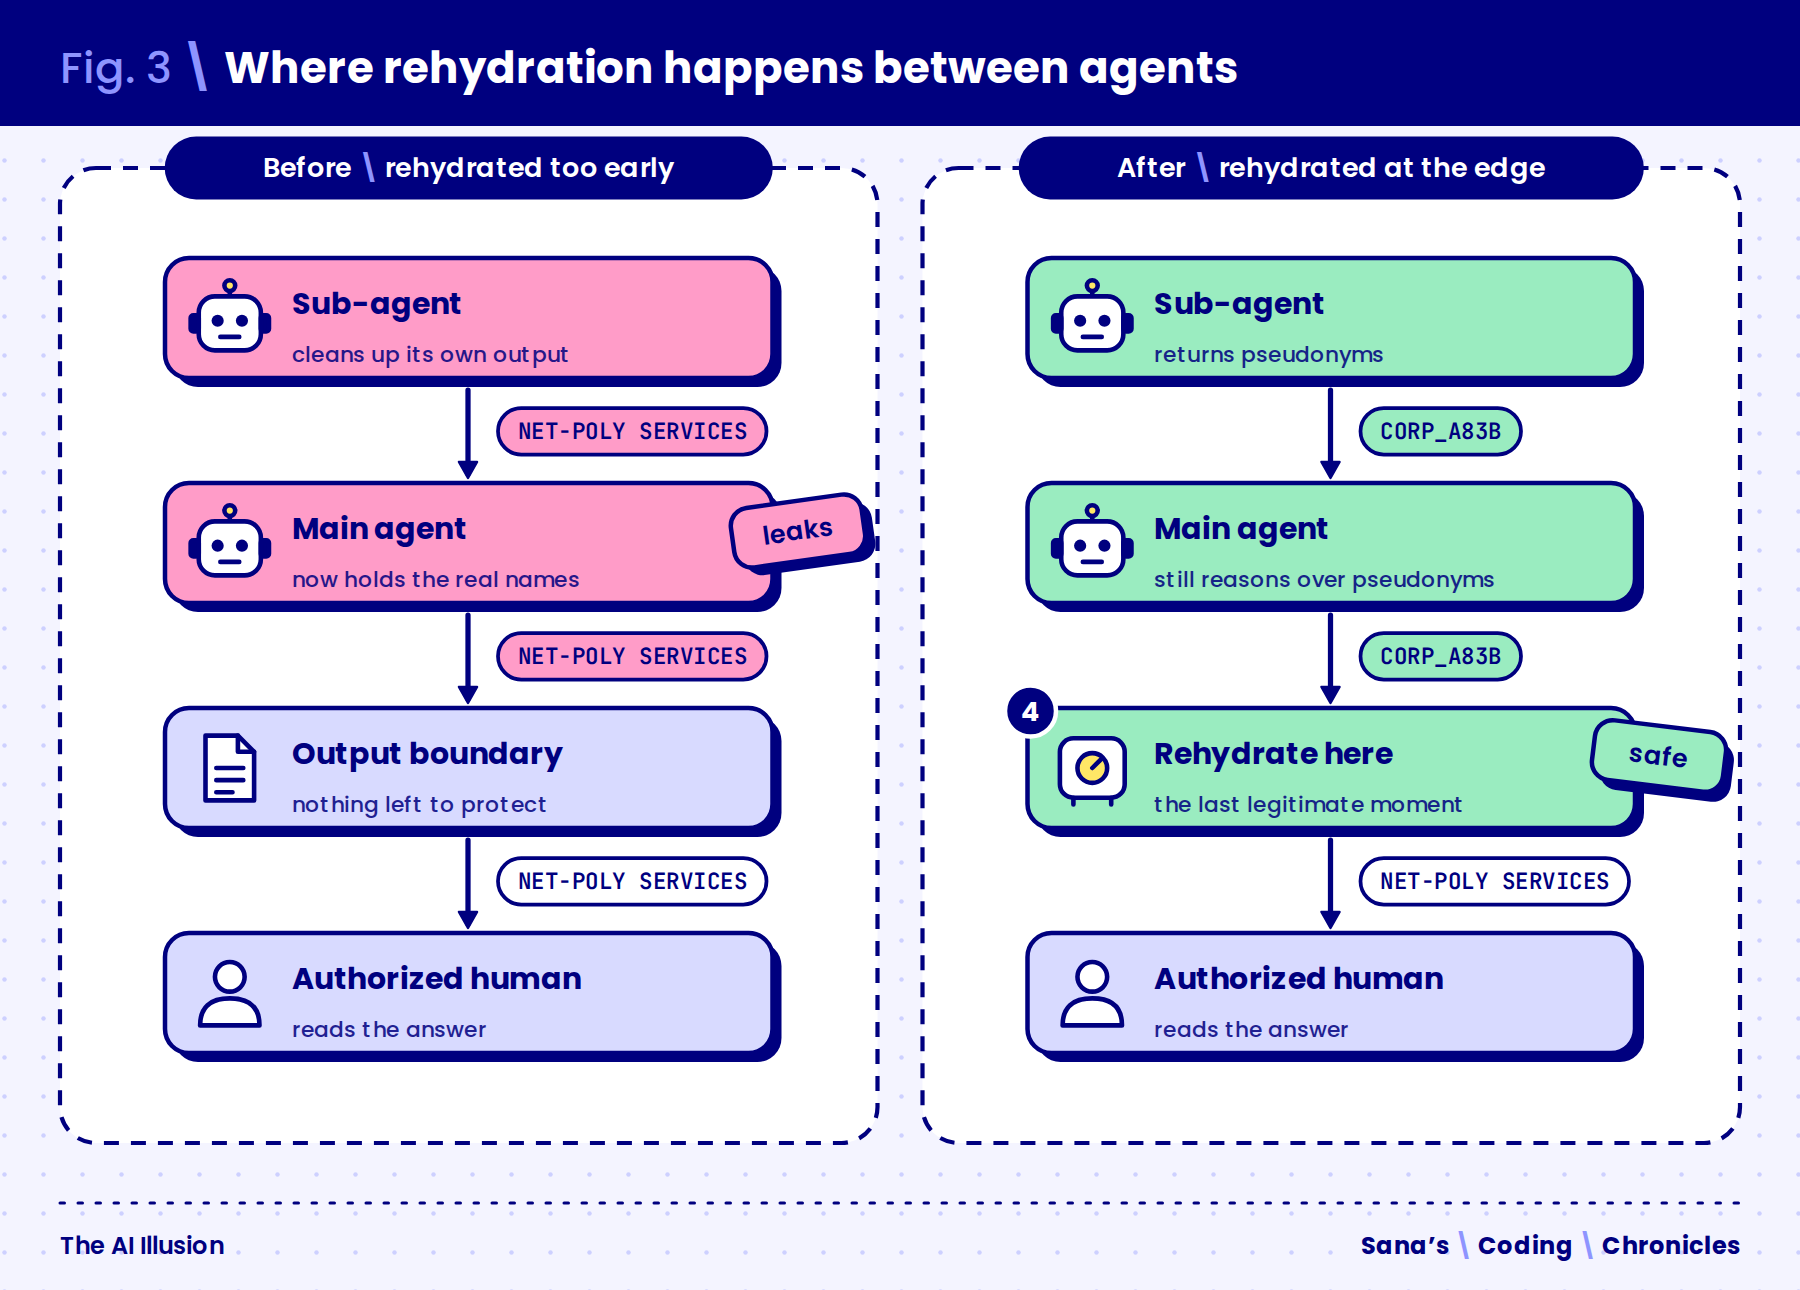 Figure 3 : Frontières de confiance lors de délégations inter-agents et déplacement du point de réhydratation.
4. Pour les ingénieurs : comment nous implémentons les invariants
Il s’agit ici d’une implémentation concrète parmi d’autres. L’outillage est spécifique à notre écosystème technique. Même si votre architecture diffère sensiblement de la nôtre, les invariants restent universels : seule leur incarnation technique change. Les lecteurs non techniques peuvent passer directement à la section 5.
- Passerelle d’anonymisation (invariant 3) : Avant toute classification, le texte libre saisi par l’utilisateur franchit une passerelle stricte combinant des bibliothèques de TALN/NLP et des règles de substitution déterministes. Les noms et identifiants sont remplacés par des jetons uniques (par exemple
CORP_A83B). La table de correspondance est immédiatement sécurisée dans un coffre-fort chiffré (encrypted vault) : calcul HMAC-SHA256 pour l’identifiant du jeton et chiffrement Fernet (AES-128-CBC avec HMAC) pour la valeur réelle au repos. - Routeur (invariant 2) : La requête pseudonymisée est soumise à un LLM délibérément compact, véloce et économique, dont l’unique mission est de classifier l’intention. Un classement, une lecture de ratio ou une extraction basique emprunte le chemin rapide (fast path) : un outil issu d’une liste blanche restreinte (allowlist) est exécuté directement, sans jamais solliciter le modèle lourd. Une analyse de risque ou une tâche d’interprétation complexe emprunte le chemin lent (slow path) et bascule vers l’agent principal.
- Outils minimisés (invariant 1) : Sur les deux chemins, l’accès aux données internes s’effectue au moyen d’outils exposés via le protocole MCP (Model Context Protocol), épurés à la source et strictement dissociés des outils réservés aux développeurs humains.
- Chemin lent (invariant 3, sortant) : Les résultats renvoyés par les outils sont systématiquement pseudonymisés avant d’être injectés dans le contexte du modèle lourd, de sorte que ce dernier raisonne et rédige exclusivement à partir de pseudonymes.
- Chemin rapide (invariant 5) : Un garde-fou de plausibilité — par exemple un ratio comparé à une valeur de référence — bloque toute réponse automatique aberrante et force un repli vers le chemin lent pour examen approfondi.
- Réhydratation (invariant 4) : Ce n’est qu’une fois la réponse finale générée et mise en forme que le système interroge le coffre-fort pour substituer les jetons par les valeurs réelles, immédiatement avant l’affichage à l’utilisateur dûment habilité.
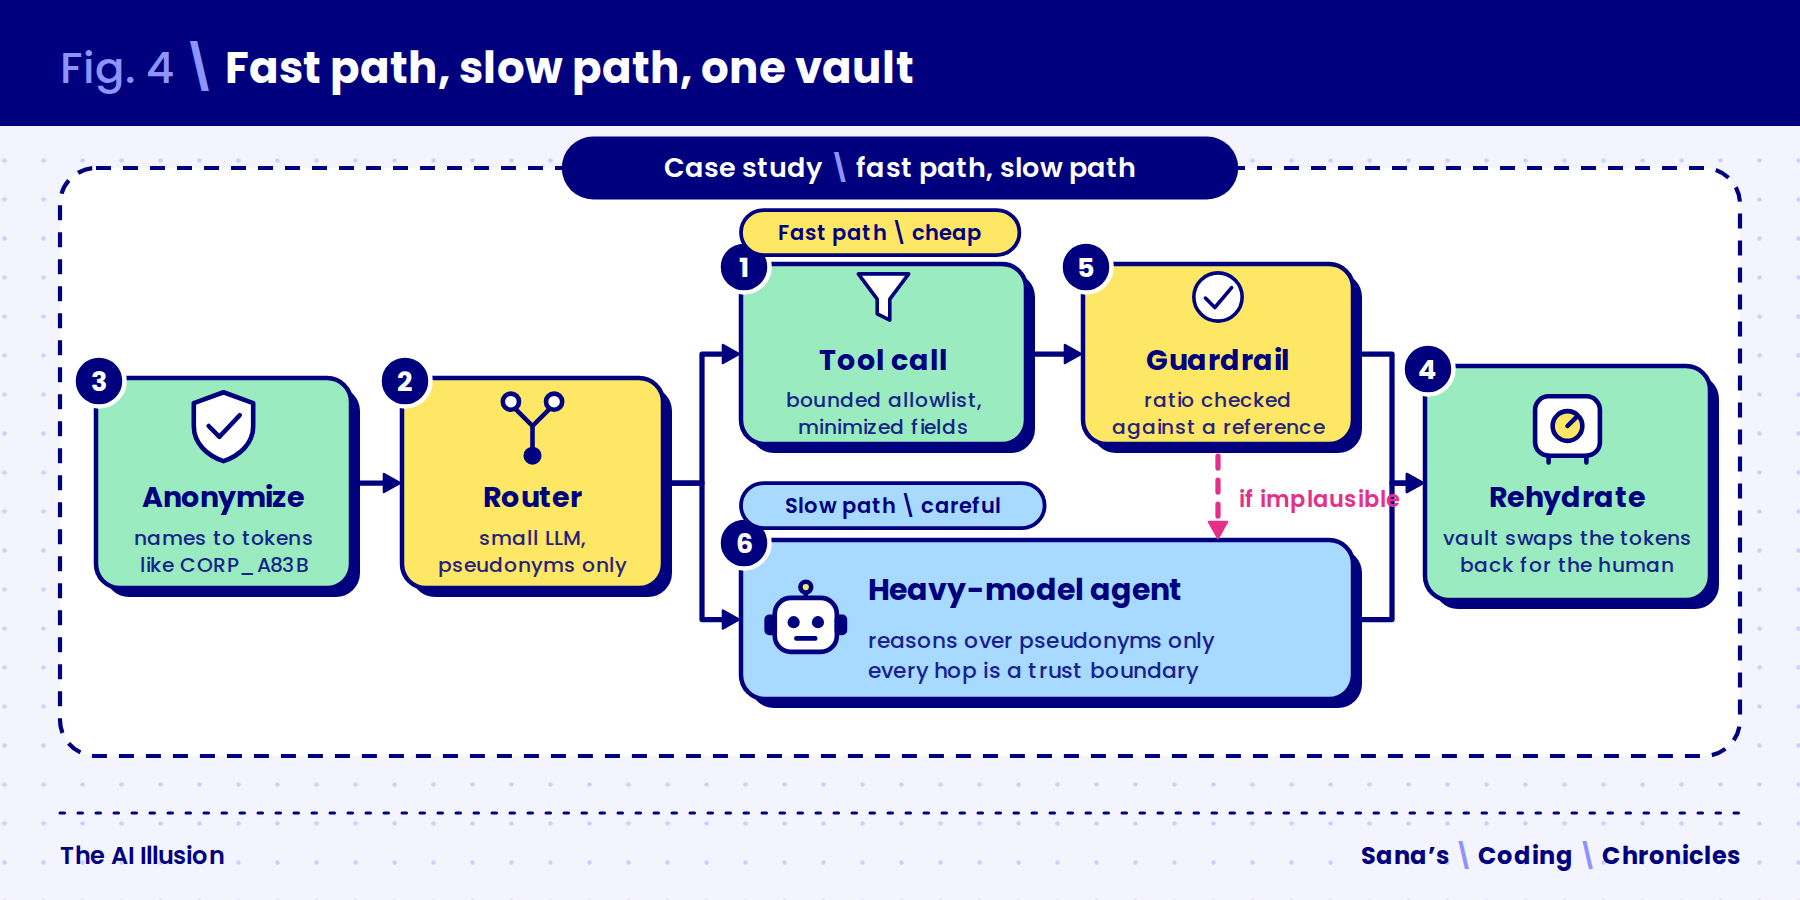 Figure 4 : Architecture de routage fast-path / slow-path.
Résultats observés : (Insérer ici vos métriques clés de production — par exemple : 72 % des requêtes traitées par le chemin rapide sans appel au modèle lourd, division par 4 de la latence médiane et réduction de 65 % des coûts d’API).
5. Vérifier plutôt que présumer
Une défense qui n’a jamais été éprouvée dans des conditions réelles est une défense dont on espère simplement l’existence.
Voici un scénario bien loin d’être théorique : un contrôle destiné à transformer chaque message avant qu’il n’atteigne le modèle a été rédigé, validé en revue de code et intégré à la branche principale. Les tests passaient avec succès. Pendant des semaines, l’équipe a cru la protection active. Elle ne l’était pas. Une hypothèse erronée sur la structure exacte de la charge utile entrante (payload shape) faisait que le filtre s’exécutait sur une mauvaise clé d’objet, de manière silencieuse, sans générer d’erreur et sans déclencher la moindre alerte.
Un test qui passe au vert sans solliciter réellement le code de protection ne prouve rien. Une revue de code n’est pas une preuve d’exécution, et un schéma d’architecture soigné n’est pas la preuve que la trajectoire tracée est celle empruntée lors de l’exécution. La seule preuve tangible repose sur un test rejoué contre le système réel : le vrai modèle, les vraies données, la véritable chaîne d’appels.
Chaque affirmation de conformité — qu’il s’agisse de « ces données sont anonymisées » ou « ces données ne sortent jamais en clair de notre réseau » — doit être assortie d’une preuve rejouable, consultable à la demande. Sans cela, il ne s’agit pas d’une garantie : c’est une hypothèse qui n’a pas encore été réfutée.
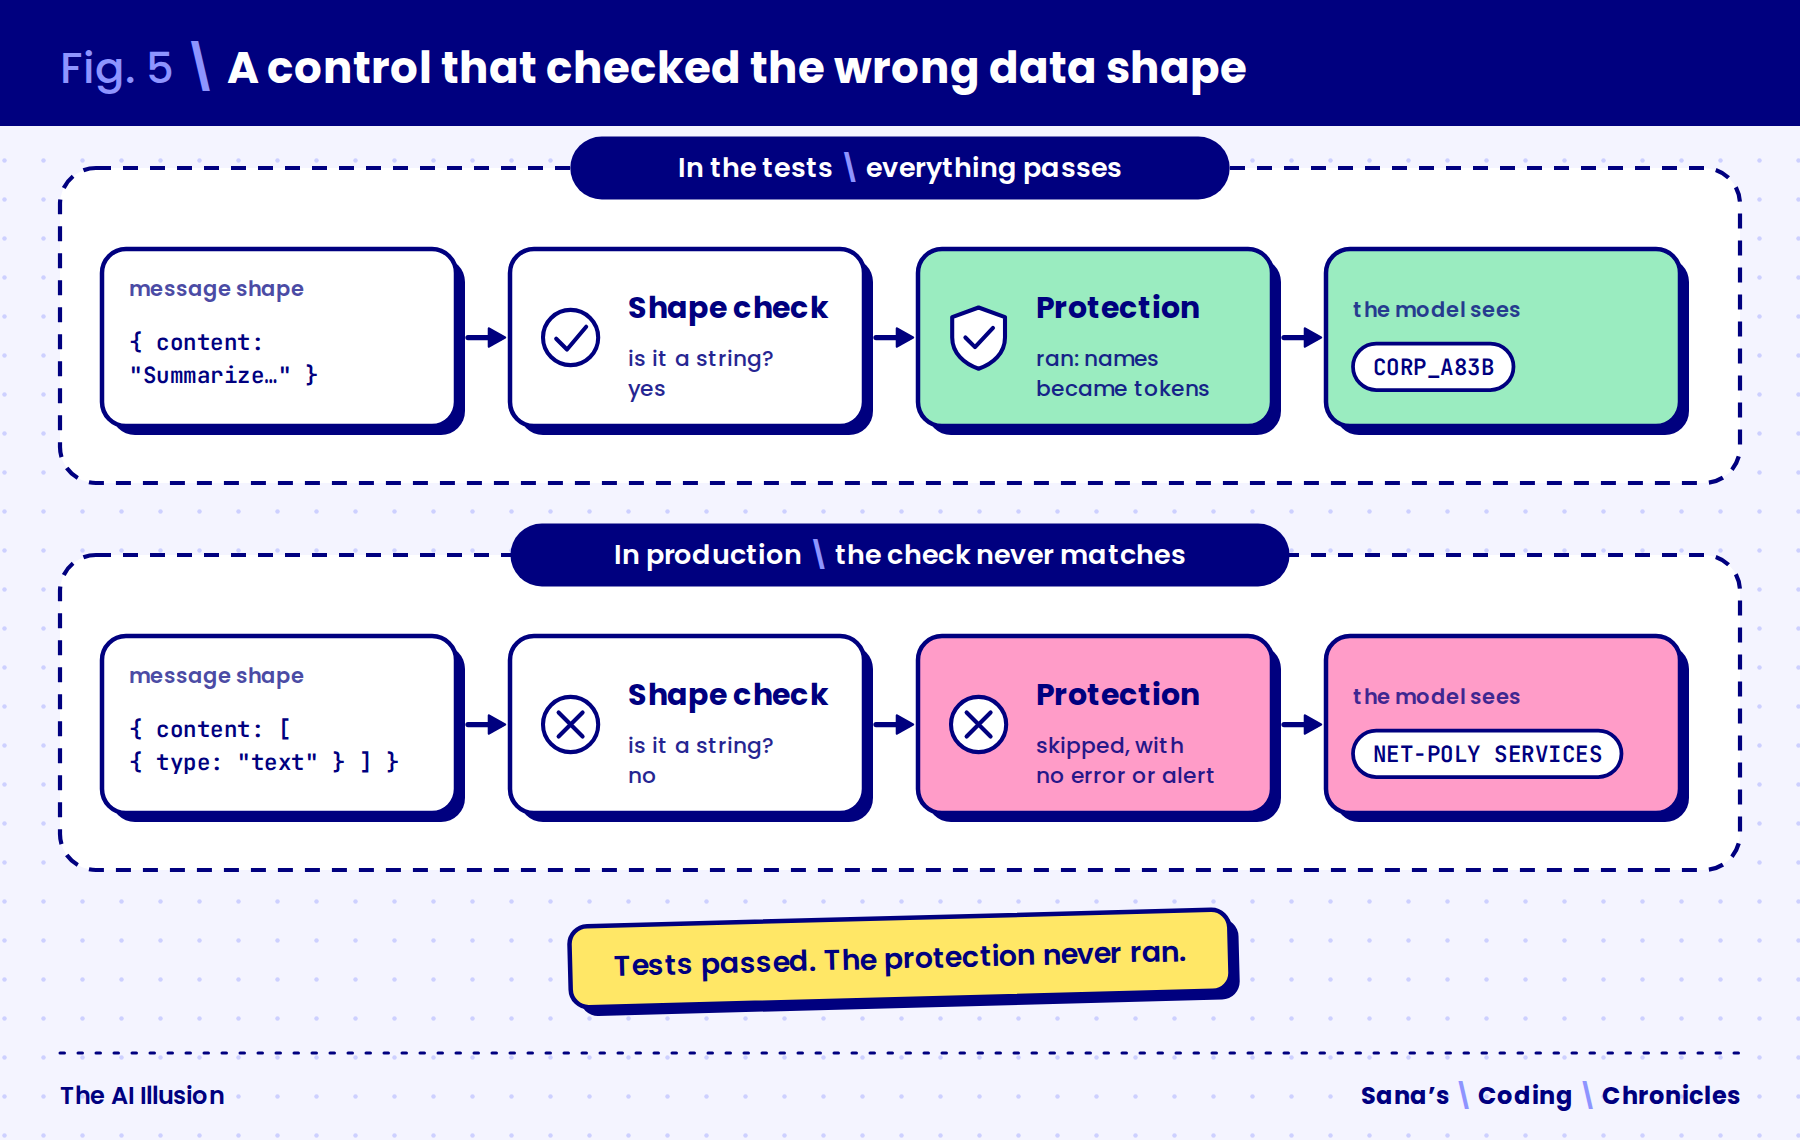 Figure 5 : Défaillance silencieuse d’un contrôle liée à une inadéquation de format des données entrantes.
6. La piste d’audit (Audit Trail)
La gouvernance ne s’arrête pas à la protection en temps réel : elle exige une traçabilité sans faille. Lorsqu’un régulateur bancaire, un auditeur RGPD ou un grand client examine la manière dont l’IA est exploitée dans votre entreprise, il ne se contentera pas de simples déclarations d’intention. Il exigera des preuves irréfutables.
Un système d’IA d’entreprise responsable conserve un journal d’audit infalsifiable (tamper-evident) et strictement en ajout seul (append-only), isolé des logs applicatifs ordinaires et de l’historique des conversations. Pour chaque événement du cycle de vie d’un agent, il consigne une paire indissociable :
- Les données brutes telles qu’elles ont été initialement reçues,
- Les données réellement transmises aux modèles externes.
La règle la plus cruciale est la suivante : aucun paramètre de configuration (feature flag) ni aucun administrateur isolé ne doit pouvoir désactiver ce journal. Lors de pics de charge imprévus, le premier réflexe d’une équipe technique est souvent de désactiver les journaux « pour préserver les performances ». Si un tel commutateur existe, le jour où une fuite survient, vous serez incapable d’en déterminer l’étendue ou d’identifier ce qui a été exposé.
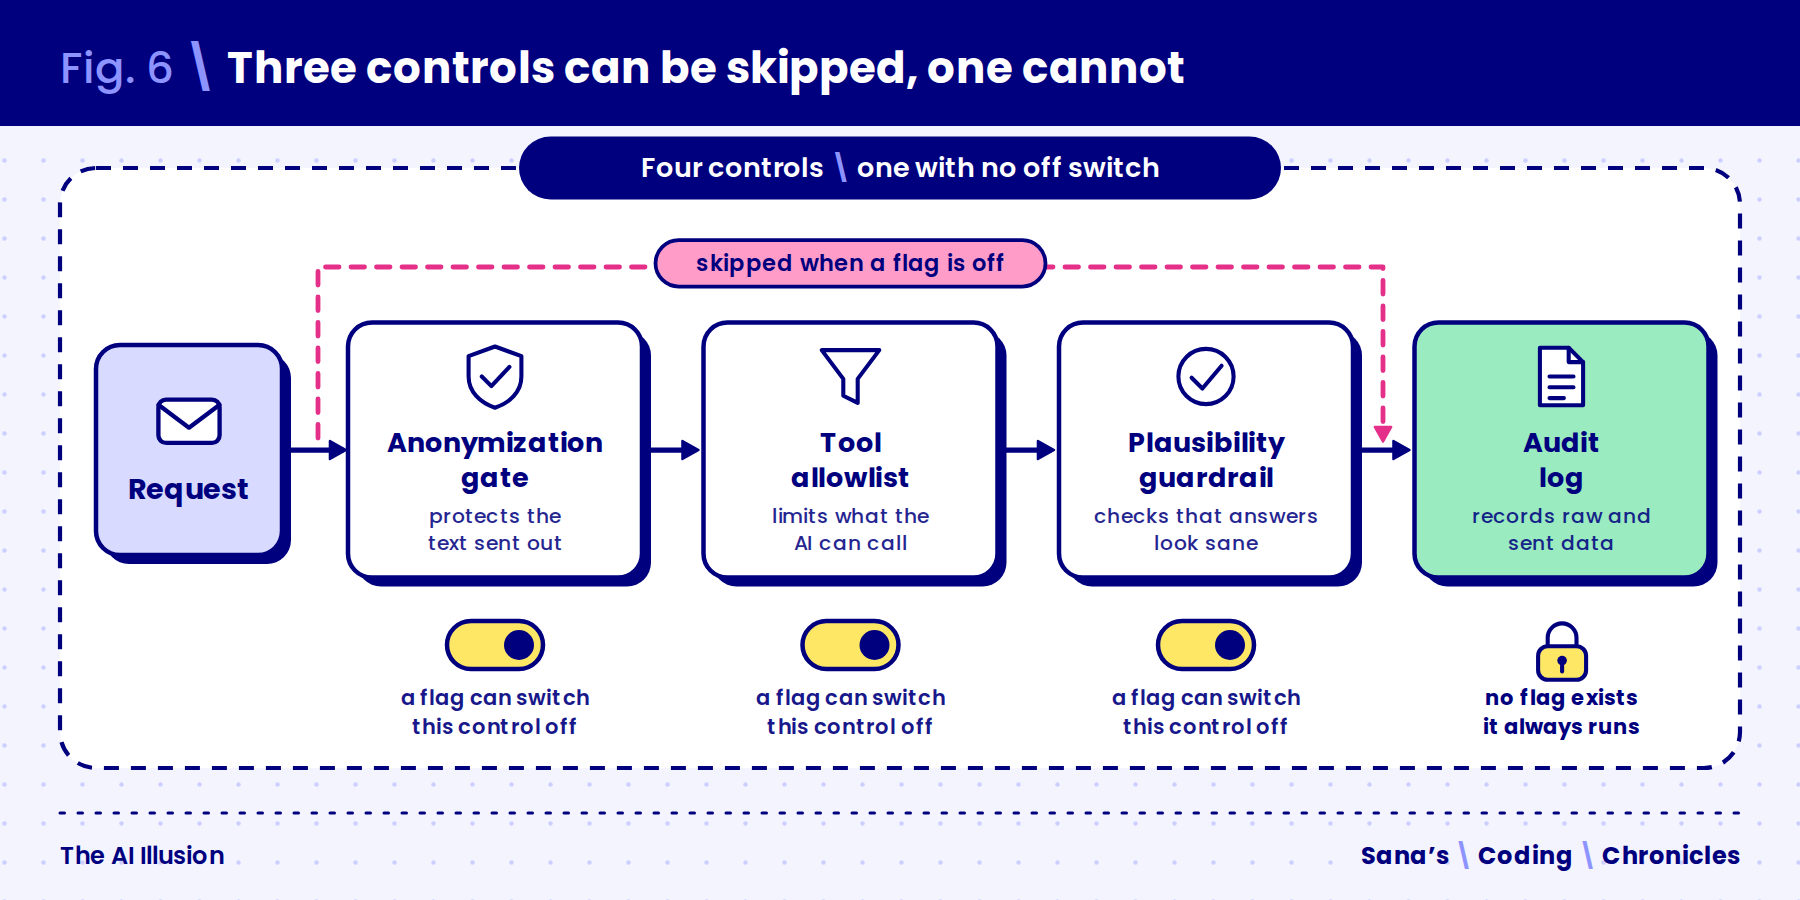 Figure 6 : Pourquoi le journal d’audit doit être immunisé contre toute désactivation par configuration.
Il y a toutefois un revers, et il doit être énoncé sans détour : ce journal d’audit devient lui-même l’un des jeux de données les plus sensibles de l’organisation, puisqu’il contient précisément les données brutes que vous avez pris tant de peine à dissimuler. Traitez-le en conséquence : chiffrez-le, cloisonnez et restreignez ses accès, fixez des limites de conservation rigoureuses, et définissez avec vos juristes la manière dont il s’articule avec les demandes de suppression (droit à l’effacement prévu par le RGPD).
Complétez enfin ce dispositif par une détection rétroactive des fuites (retroactive leak scanning) : des processus d’arrière-plan analysent en continu l’historique d’audit archivé à la recherche de schémas sensibles ayant pu franchir les premiers filtres. Lorsqu’une anomalie est décelée, le scanner ne modifie en aucun cas le journal initial : il déclenche une alerte auprès de l’équipe de sécurité, qui peut ainsi durcir les règles de filtrage avant qu’une simple brèche ne devienne un incident majeur.
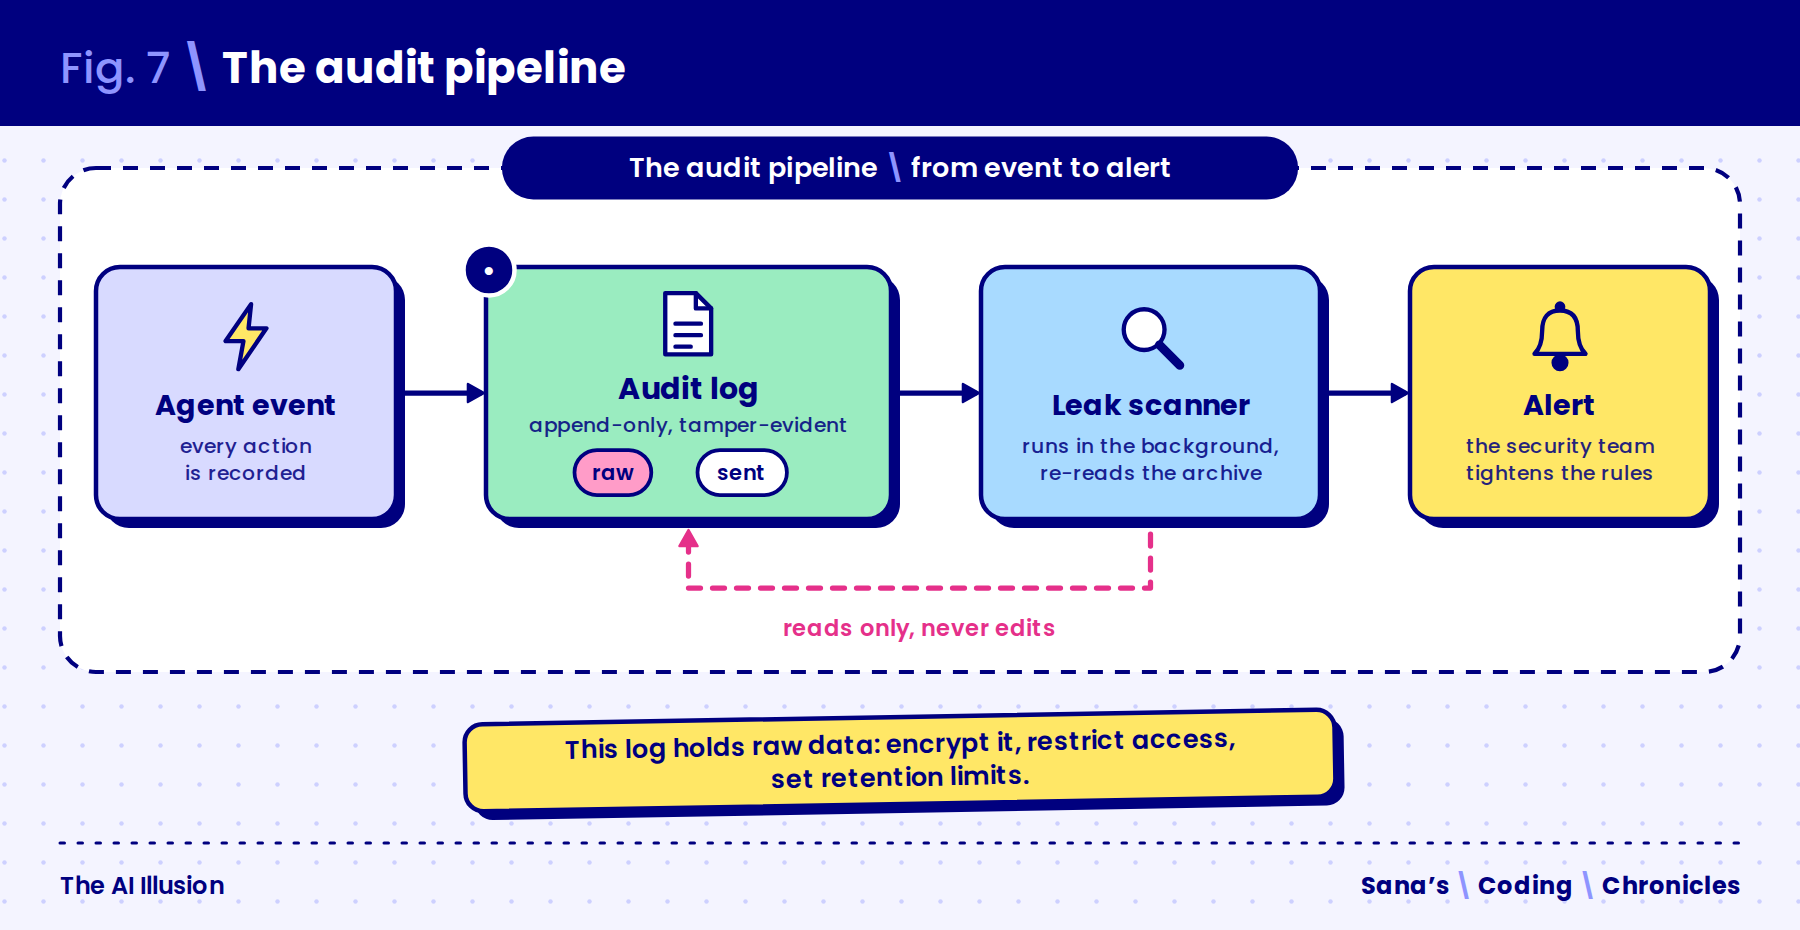 Figure 7 : Le pipeline d’audit, de l’enregistrement immuable à l’analyse asynchrone et aux alertes.
7. Conclusion : L’IA est d’abord un défi de Data Engineering
L’adage bien connu « garbage in, garbage out » a désormais un pendant moderne : « secret in, exposure out » (données secrètes en entrée, fuites en sortie). L’IA n’est pas un vernis cosmétique que l’on vient greffer à la hâte dans un recoin du système d’information pour contenter la direction générale. Elle bouleverse la façon dont l’information circule, se segmente, s’anonymise et s’archive.
Les entreprises qui sortiront gagnantes de la révolution de l’IA ne seront pas celles qui auront déployé le plus d’agents dans l’urgence. Ce seront celles qui auront d’abord bâti des fondations hermétiques et fiables. C’est la qualité des freins qui permet à une voiture de rouler vite. Une fois ces contrôles fermement en place, les équipes peuvent donner leur feu vert à un plus grand nombre de cas d’usage, avec moins de débats interminables et sans vetos de dernière minute.
Alors, avant de signer votre prochain contrat de licence d’IA ou de célébrer le déploiement de votre nouvel agent autonome, rassemblez vos architectes et posez-leur une seule question :
« Si un auditeur externe mandaté par notre plus grand client débarquait demain matin à 8h, seriez-vous capables de me prouver, ligne de code par ligne de code, qu’aucun nom, aucun identifiant et aucun chiffre confidentiel n’a quitté notre réseau en clair au cours du mois écoulé ? »
Si la réponse est un silence gêné, un renvoi aux « clauses contractuelles du fournisseur » ou la mention d’« un prompt qui demande à l’IA d’être prudente », vous connaissez déjà votre prochain projet.
La checklist de gouvernance : 8 cases à cocher
Avant de quitter la salle, voici les huit critères non négociables à valider (les six invariants, complétés par les impératifs des sections 5 et 6) :
- Minimisez-vous dès la source ? (Invariant 1)
- Préservez-vous le modèle lourd et coûteux des requêtes simples ? (Invariant 2)
- Chaque frontière texte-vers-modèle fait-elle l’objet d’une protection réversible ? (Invariant 3)
- Ne réhydratez-vous qu’au tout dernier moment légitime ? (Invariant 4)
- Un garde-fou déterministe a-t-il le dernier mot sur la plausibilité ? (Invariant 5)
- Chaque saut d’agent à agent constitue-t-il sa propre frontière de confiance ? (Invariant 6)
- Chaque contrôle est-il vérifié en conditions réelles, et pas seulement supposé fonctionnel ? (Section 5)
- Le journal d’audit est-il impossible à désactiver par configuration ou par un administrateur isolé ? (Section 6)
-
Alex Kim, « The Claude Code Source Leak: fake tools, frustration regexes, undercover mode, and more », 31 mars 2026. La fuite provenait d’un fichier source map publié par mégarde sur npm. Le fichier
userPromptKeywords.tscontient la regex employée pour la détection de la frustration de l’utilisateur. ↩